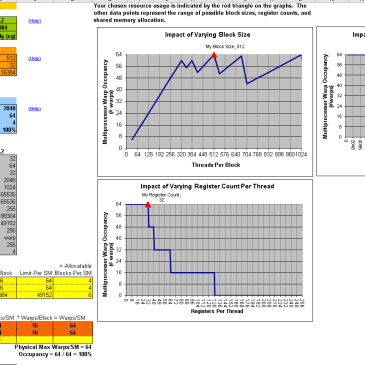
CUDA를 이용한 복셀 월드의 라이트맵 계산 – 성능개선

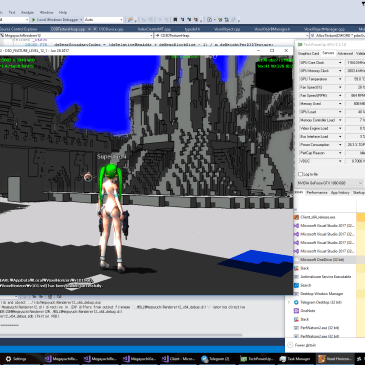
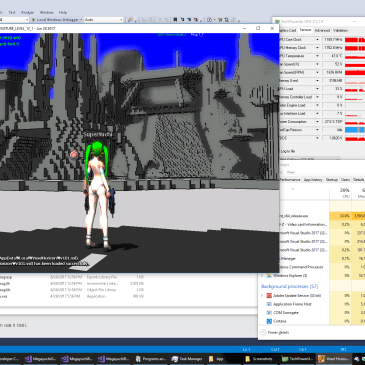
엊그제 포스팅했던 CUDA를 이용한 라이트맵 베이킹의 성능향상에 대한 얘기다. 좀더 GPU를 빡시게 사용하려고 cuda Stream + 멀티스레드 까지 적용했는데 생각보단 성능이 많이 오르지 않는다. 프로파일링 해보니 Occupancy가 이론상 50% 달성할 수 있는데 실제로는 29.3%만 달성한 것으로 나온다. Occupancy가 영 만족스럽지 못하다. 그래서 이런저런 튜닝을 좀 했다. 오랫만에 Occupancy Calculator를 실행해서 SM 5.2와 6.1기준으로 숫자를 넣어 … More CUDA를 이용한 복셀 월드의 라이트맵 계산 – 성능개선
CUDA + Lightmap 관련 잡설

예전에 NDC에서 발표했던 자료. 참고로… 라이트맵은 15년전에 만든 엔진에도 들어가 있었고 코룸온라인/묵향 온라인에 적용해서 서비스했었다. blur도 들어가지 않은 raw라이트맵이었다. 그래도 그 시절엔 꽤 괜찮아보였다. 후에 이소프넷 망하고 묵향쪽이 분사하면서 라이트맵 베이킹도 안하게 됐다. 나도 다른 회사 갔고 그 회사엔 더 이상 코드 유지보수할 사람도 툴 사용법을 제대로 아는 사람도 없어서 그냥 깔끔하게 포기했던걸로 안다. 당시에 … More CUDA + Lightmap 관련 잡설

D3D12예제에서 Constant Buffer를 System Memory에 두는 이유.

D3D12 예제를 보면 Constant Buffer를 system memory에 만들어 사용하고 있다. (CPU write, GPU read). D3D11에선 Constant Buffer를 GPU메모리에 두느냐, 시스템 메모리에 두느냐에 따라 성능차이가 꽤 난다. 20-30%정도는 차이가 나는것 같다. D3D12에서 테스트해보면 대략 10%정도 성능 차이가 난다. 당연히 GPU메모리에 두는 쪽이 빠르다. 크다면 크고 작다면 작은 수치다. 그럼 왜 D3D12예제에선 시스템 메모리에 Constant Buffer를 잡았을까. … More D3D12예제에서 Constant Buffer를 System Memory에 두는 이유.

SW Occlusion Culling 정리

요 근래 계속 붙잡고 있던 SW Occlusion Culling을 거의 마무리 지었다. 물론 오래전에 HW Hierarchical Occlusion Culling을 구현해서 지금까지도 잘 사용하고 있다. SW Occlusion Culling을 만든 이유는 HW Occlusion Culling을 대체하기 위함이 아니다. 전혀 아니다. 이것은 완전히 용도가 다르다. 현재 복셀 월드는 KD-Tree로 공간이 분할되어있다. 그리고 보여지는 오브젝트를 찾아내기 위해 트리를 탐색한다. 이 탐색 과정에서 … More SW Occlusion Culling 정리

SSAO적용.

SSAO적용. 아직 손볼곳이 많지만 대충 구현은 완료. 현재 directional라이트만 적용했더니 복셀이 너무 밋밋해 보여서 SSAO를 넣었다. 확실히 복셀 오브젝트에선 SSAO가 있는 편이 나은것 같다. 캐릭터에선 빼는게 좋겠고. Compute Shader로 구현했는데 덕택에 UWP on XBOX버전엔 당장은 적용 못한다. UWP on XBOX에선 DX Feature Level 10까지만 지원하니까 Compute Shader를 쓸 수 없다. Pixel Shader버전으로 다시 짜줘야하는데 귀찮네. … More SSAO적용.

Hi-Z Occlusion Culling vs D3DQuery Occlusion Culling

HW Occlusion Culling을 써야할 상황이라면…명백하게 D3DQuery보다 Hi-Z Occlusion Culling이 빠르다. 다만 Hi-Z Occlusion Culling보다는 D3DQuery쪽이 더 정밀하게 culling할 수 있다. 일반적으로 카메라가 변경되거나 오브젝트의 배치가 변경될때만 Occlusion Culling을 한다. 당연히 카메라가 고정된 상태에선 Hi-Z는 D3DQuery든 쓸 수 있는 culling은 다 쓰는게 프레임 레이트가 잘 나온다. 문제는 주인공 캐릭터가 움직이거나 해서 카메라가 변경될때인데 이 경우 Hi-Z … More Hi-Z Occlusion Culling vs D3DQuery Occlusion Culling

DX12엔진에서 64KB Align문제 해결 – Texture

몇일전 포스팅 했다시피 DX12에선 모든 D3DResource가 64KB Align을 요구하고, 그래서 1Byte짜리 버퍼만 할당해도 64KB짜리가 할당된다. Voxel Horizon은 상당히 많은 개수의 Voxel-Object를 만들어내므로 DX12버전에선 GPU메모리를 미친듯이 먹고 있었다. 앞선 포스팅에서 언급했다시피 Vertex Buffer와 Index Buffer에 대해서는 직접 만든 heap에 64KB Align된 D3DResource를 결합해서 해결했다. 그리고 Texture가 남았다. 이게 처음에 좀 난감했다.  왜냐하면 1차원 버퍼가 아니고 2차원 … More DX12엔진에서 64KB Align문제 해결 – Texture

DX11 vs DX12 리소스 사용량

어쩐지 무겁더라… Voxel Horizon의 DX12버전을 작업하던중 너무 무겁다고 생각했다. Project D Online의 dx12버전은 dx11버전에 비해 50%만(?) 메모리(GPU/GPU Mapped System Memory)를 더 먹었지만 Voxel Horizon프로젝트에선 8배를 더 처먹는다! Voxel Horizon은 정해진 맵데이터가 없는 대신 최대 8x8x8개의 복셀로 이루어진 수만개의 복셀 오브젝트가 존재한다. 복셀 오브젝트 한개당 Vertex Buffer 1개, Index Buffer 2개, Texture 1개를 만드는데 얘네들이 64KB얼라인이 … More DX11 vs DX12 리소스 사용량

Voxel Horizon – Voxel Data Streaming from Server #2

서버로부터 Voxel 데이터 수신 후 3D Mesh빌드. 체감상 1프레임도 안떨어지는 정도로 개선했다. 서버로부터 Voxel데이터 수신 -> 멀티스레드로 Voxel데이터 -> 삼각형 매시 변환, 라이트 계산을 위한 Patch데이터 생성 -> 멀티스레드로 라이트 계산 이 과정으로 진행된다. 라이트 계산이 좀 오래 걸리는데 대략 20ms정도 초과하면 일단 끊고 라이트 계산을 종료하도록 했다. 라이트 계산을 완료하지 못한 오브젝트들은 라이트 계산을 … More Voxel Horizon – Voxel Data Streaming from Server #2

Voxel Horizon – Voxel Data Streaming from Server

지금껏 내가 만든 게임엔진+기반 플랫폼은 언제나 로딩 속도가 충분히 빨랐기 때문에 지연로딩같은건 사용해본적이 없다.  뻥 안까고 캐릭터 로딩할때 아무도 캐릭터 로딩하는줄 모르는 정도로 빠르게 만들었다. 맵로딩할때도 로딩이 너무 빨라서 로딩시간에 보여주는 일러스트를 볼 수 없으니 로딩시간을 느리게 해달라는 요구도 받은적이 있다. 하지만 이번의 경우는 복셀 데이터를 서버에서 스트리밍 해야하고 데이터량이 적지 않을뿐더러 복셀데이터->삼각형데이터->(최적화된 충돌처리용 삼각형매시, … More Voxel Horizon – Voxel Data Streaming from Server